Jev 대안이라던 laya를 써보고 Jev로 돌아온 이야기
LLM의 분류 작업을 자동화하기 위해 오픈소스 laya를 도입했으나 낮은 정확도와 신뢰성 문제로 결국 Jev로 돌아온 경험을 공유합니다. 판정 모델 선택 시 벤치마크 수치보다 실제 데이터에서의 확신도 신뢰성이 중요하며, Jev의 높은 정확도와 확신도를 활용해 자동화 파이프라인을 효율적으로 구축한 과정을 정리했습니다
Claude Code 로 일하다 보면 비슷한 부탁을 자주 하게 된다. 이슈 수백 건을 버그인지 개선 요청인지 나눠 달라거나, 로그 줄을 심각도별로 묶어 달라거나. 라벨은 이미 정해져 있고 항목만 많은 일이다. LLM 에 통째로 맡기면 되긴 하는데 느리고, 돌릴 때마다 결과가 조금씩 달라서 늘 찜찜했다.
그러다 텍스트를 생성하지 않고 판정만 내리는 모델이 있다는 얘기를 들었다. TypeSafe 의 Jev 가 요즘 꽤 화제고, 그 대안으로 오픈소스 laya 를 쓴다는 글도 여럿 보였다. 로컬에서 돌고, 무료고, 한 번 판정하는 데 33ms 라고 했다. 그래서 laya 부터 붙여 봤다. 결론부터 말하면 laya 는 하루 만에 지웠고 지금은 Jev 를 쓴다. 그 과정을 정리해 둔다.
판정 모델이 뭔가
보통 LLM 은 답을 한 글자씩 써 내려간다. 분류를 시키면 "bug" 라는 단어를 생성하고, 우리는 그걸 다시 파싱한다. 판정 모델은 그 과정을 건너뛴다. 상태(텍스트나 JSON)와 질문, 선택지를 주면 한 번의 계산으로 선택지별 확률을 돌려준다. 생성을 하지 않으니 없는 라벨을 지어낼 일이 없고, 확률이 같이 나오니 모델이 얼마나 확신하는지도 알 수 있다.
질문 형식은 Jev 와 laya 가 거의 같다. laya 가 Jev 의 형식을 따라 만들었기 때문이다.
{
  "state": "결제가 두 번 됐어요. 환불해 주세요.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "어느 팀이 처리해야 하나?",
      "criteria": { "billing": "결제와 환불", "technical": "버그와 장애" }
    }
  }
}
laya 를 로컬에 붙이기
M3 Pro 맥북에 설치했다. 처음엔 도커로 관리할까 했는데, 맥의 도커는 리눅스 가상머신 위에서 돌아서 Metal GPU 를 못 쓴다. CPU 로 떨어지면 몇 배는 느려지니 그냥 가상환경에 설치하고, 여러 세션이 같이 쓰도록 작은 로컬 데몬을 하나 띄웠다. 20분 동안 요청이 없으면 알아서 꺼지게 해 두었다.
설치하면서 재미있는 걸 하나 발견했다. 모델 하나 로드하는 데 30초가 걸렸는데, 프로파일을 떠 보니 그중 23초가 가중치를 무작위로 초기화하는 데 쓰이고 있었다. 뼈대를 만들 때 transformers 가 모든 가중치를 난수로 채우고, 바로 다음 줄에서 저장된 가중치로 전부 덮어쓰는 구조였다. 초기화를 건너뛰도록 감쌌더니 1초 안팎으로 줄었고, 출력은 완전히 같았다.
from transformers.initialization import no_init_weights

with no_init_weights():
    agent = laya.load("convaiinnovations/laya")
속도도 괜찮았다. 짧은 문장은 판정 한 번에 20~40ms, 파일 하나를 통째로 넣어도 0.1초 남짓이었다. 여기까지는 기대한 그대로였다.
실제 데이터에서는 30%
문제는 정확도였다. 벤치마크 숫자 말고 내 데이터로 재 보고 싶어서, 정답이 이미 있는 데이터를 골랐다. 옵시디언 노트는 들어 있는 폴더가 정답이고, 코드는 기능별 디렉터리가, 커밋은 feat, fix 같은 접두어가 정답이다. 따로 라벨을 만들 필요가 없었다.
결과는 좋지 않았다. 한국어 업무 노트를 12개 도메인으로 나누는 과제에서 30%, 커밋 유형 맞히기에서 32%, 영어 코드 파일도 46% 였다. 무작위보다는 낫지만 믿고 맡길 수준은 아니었다.
마지막으로 laya 가 원래 잘한다는 티켓 분류로 한 번 더 확인했다. 회사 서비스의 GitHub 이슈 100건에 내가 먼저 정답을 매겨 두고(유형 5개, 기능 영역 11개), laya 에는 같은 라벨 정의만 줘서 분류시켰다. 두 축을 모두 맞힌 건 30건이었다. 유형만 놓고 보면 67% 인데, 전부 bug 라고 찍어도 56% 가 나오는 데이터라 사실상 거의 못 맞힌 셈이다.
더 곤란했던 건 확신도였다. "ㅁㄴㅇ" 같은 의미 없는 입력을 67% 확신으로 bug 라고 했고, 여러 파일을 골라 다운로드하면 한 개만 받아진다는 이슈를 기능 영역 '프로젝트' 로 100% 확신했다. 본문에 '프로젝트 파일함' 이라는 단어가 들어 있었을 뿐이다. 확신도가 높은 것만 골라 쓰면 되지 않을까 싶었는데, 틀린 답도 확신도가 높으니 걸러낼 방법이 없었다.
README 에 이미 적혀 있었다
돌아보면 답은 README 에 있었다. 맨 위에는 laya 가 Jev 보다 정확하다는 비교표가 있는데, 그 숫자는 해당 벤치마크의 학습 데이터로 파인튜닝한 모델의 결과다. 같은 과제에서 튜닝 전 기본 모델은 0.36 으로, 전부 한 가지로 찍는 기준선보다도 낮다. 한계를 설명하는 섹션에는 튜닝해서 쓰는 베이스이지 제로샷 판정 엔진이 아니라고 분명하게 적혀 있었다.
모델 크기도 다르다. laya 는 3억에서 4억 파라미터짜리 BERT 계열 인코더다. 한국어 입력은 그보다 작은 다국어 모델로 가고, 사내 용어는 당연히 모른다. 라벨을 모아 파인튜닝하면 달라지겠지만, 매번 질문이 바뀌는 내 용도와는 맞지 않았다.
Jev 로 다시 재기
Jev 는 TypeSafe 에 가입하려 했더니 인원이 꽉 찼다며 막혀 있었다. 대신 OpenRouter 에서 쓸 수 있다. 처음에는 OpenRouter 모델 목록에 Jev 가 없어서 없는 줄 알았는데, 목록에서만 빠져 있고 모델 상세 페이지와 API 는 멀쩡히 살아 있었다. 목록 하나만 보고 판단하면 안 된다는 걸 여기서 배웠다.
한 가지 주의할 점은 채팅 API 가 아니라는 것이다. OpenAI 호환 엔드포인트로는 호출할 수 없고, 판정 전용 엔드포인트를 쓴다. 요청 형식은 위에서 본 것과 같다.
curl https://openrouter.ai/api/alpha/decisions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "typesafe/jev-1.13", "state": "결제가 두 번 됐어요", "questions": {"team": {"type": "choice", "instructions": "어느 팀이 처리해야 하나?", "criteria": {"billing": "결제와 환불", "technical": "버그와 장애"}}}}'
같은 이슈 100건, 같은 라벨 정의로 돌렸다. 비교를 위해 Gemini 3.8 Flash 에 100건을 한 번에 넣어 분류시키는 방식도 같이 쟀다.
| 방식 | 두 축 모두 맞음 | 100건 처리 시간 | 비용 |
|---|---|---|---|
| laya (로컬) | 30% | 11초 | 무료 |
| Gemini 3.8 Flash, 한 번에 배치 | 85~98% | 21~75초 | 구독 |
| Jev 1.13, 동시 8개 | 88~89% | 6초 | 약 0.0046달러 |
Jev 가 좋았던 점
첫째는 속도다. 한 건에 0.3초 정도라 동시에 여러 개를 보내면 100건이 6초 만에 끝난다. LLM 은 한 번 호출하는 데 20초가 넘게 걸려서 여러 건을 한꺼번에 묶어야 효율이 나오는데, Jev 는 작업하다가 한 건씩 물어봐도 부담이 없다.
둘째는 비용이다. 입력 100만 토큰에 0.042달러이고 출력에는 돈을 받지 않는다. 이슈 100건을 두 가지 질문으로 분류하는 데 0.5센트가 안 들었다.
셋째가 제일 중요한데, 확신도를 믿을 수 있다. 확신도가 0.8 이상인 답만 모아 보면 거의 다 맞았다. 첫 실행에서는 유형 78건, 영역 62건이 전부 정답이었고, 두 번 돌린 결과를 합쳐도 96건 중 95건이 맞았다. laya 에서 가장 아쉬웠던 부분이 정확히 여기였다.
정확도 자체는 LLM 과 비슷하거나 조금 낮다. 틀린 건 대부분 기능 영역의 경계가 애매한 이슈였다. 프로젝트 화면에서 미리보기가 안 된다는 이슈를 '미리보기' 로 볼지 '프로젝트' 로 볼지 같은 것들인데, 정답을 매긴 나도 헷갈렸던 부분이다.
그래서 이렇게 쓴다
확신도를 믿을 수 있으니 역할을 나눌 수 있다. Jev 가 먼저 전부 분류하고, 확신도가 0.8 이상인 건 그대로 쓴다. 나머지만 모아서 LLM 에 한 번에 넘긴다.
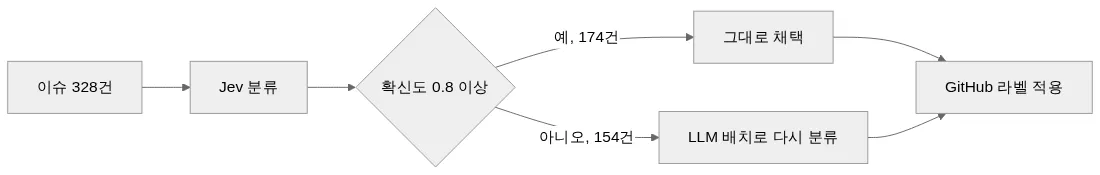
실제로 이슈 328건 전체를 이렇게 처리했다. Jev 가 14초 만에 전부 분류했고 그중 174건을 그대로 채택했다. 남은 154건은 Gemini 가 40초 동안 처리했다. 정답을 알고 있는 100건으로 확인해 보니 92건이 맞았다. 결과는 GitHub 라벨로 붙여 두었고, 틀린 건 보이는 대로 사람이 고치면 된다.
정리
laya 에 들인 하루가 아깝지는 않다. 몇 가지를 배웠다.
벤치마크 헤드라인보다 한계 섹션을 먼저 읽어야 한다. 그리고 정답이 있는 내 데이터로 30분만 재 보면 대부분 판가름이 난다. 폴더 구조나 커밋 접두어처럼 이미 정답이 붙어 있는 데이터는 생각보다 가까이에 있다.
판정 모델에서 정확도만큼 중요한 건 확신도가 맞느냐다. 확신도를 믿을 수 있으면 쉬운 건 자동으로 처리하고 어려운 것만 사람이나 큰 모델에 넘기는 구조를 만들 수 있다. 확신도가 틀리면 결과 전체를 다시 봐야 해서 쓰는 의미가 없어진다.
마지막으로, 무료이고 로컬에서 돈다는 장점은 정확도가 받쳐 줄 때만 의미가 있다. 이슈 100건에 0.5센트라면 굳이 로컬을 고집할 이유가 없었다.